Monitoree continuamente las respuestas de sus APIs en cuanto a velocidad, rendimiento y disponibilidad.


25regiones cloud
1mes de retención de datos, gratis
10.000ejecuciones al mes, gratis
1 minfrecuencia de check más rápida, en los planes de pago
Monitorización del rendimiento de API: tiempo de respuesta y latencia
Ve en qué gasta el tiempo cada petición
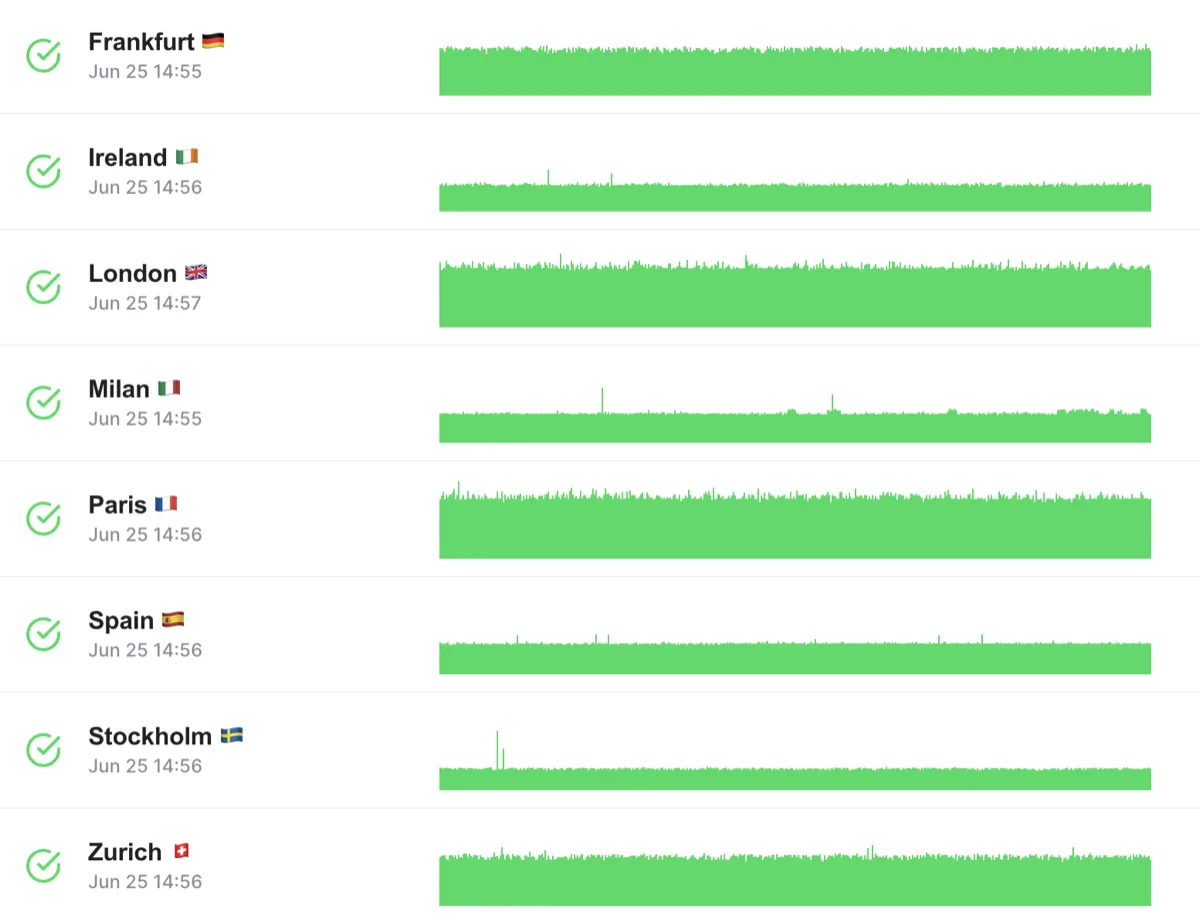
Cada ejecución divide el tiempo de respuesta en espera, DNS, conexión TCP, primer byte y descarga, para que sepas qué parte se ha vuelto lenta.
Detecta la lentitud antes de la caída
Define un umbral de degradación del tiempo de respuesta y recibe un aviso cuando un endpoint se vuelve lento, antes de que empiece a fallar.
Historial suficiente para ver la deriva
Free guarda un mes de resultados, Starter 3 meses y Professional 12, así que las ralentizaciones graduales aparecen en los gráficos.
Ventajas del monitoreo de API en tiempo real
Checks hasta una vez por minuto
Free comprueba cada 5 minutos; Starter y Professional, cada minuto.
Menos falsas alarmas
Los reintentos, un umbral de fallos consecutivos y un mínimo de ubicaciones con fallo evitan que una región inestable te despierte.
Alertas al fallar y al recuperarse
Recibe avisos por email, Slack, Microsoft Teams o webhook en todos los planes, y además Discord, PagerDuty y Opsgenie en los planes de pago, y otra vez cuando la API vuelve a estar bien.
Análisis completo de salud de la API
Comprueba algo más que el código de estado
Comprueba el código de estado, el cuerpo de la respuesta, las cabeceras y el tiempo de respuesta, para que un 200 con datos incorrectos también falle.
Checks de varios pasos para flujos reales
Inicia sesión, pasa el token a la siguiente petición y comprueba cada paso, con las variables y los secretos fuera del propio check.
Informes de SLA a partir de checks reales
Los informes de SLA y SLO convierten el historial de checks en cifras de disponibilidad que puedes compartir con tus clientes.
Elija LoadFocus para el monitoreo de APIs
Monitorización y pruebas de carga en una sola cuenta
Cuando un check muestra que un endpoint se ralentiza, lanza una prueba de carga contra él desde la misma cuenta para encontrar su límite.
Páginas de estado incluidas
Publica una página de estado alimentada por tus checks, con una página incluida en el plan gratuito.
Monitoring as Code
Define los checks en YAML y despliégalos desde tu CI con la CLI, o gestiónalos desde un asistente de IA a través del servidor MCP.
Monitoreo global de API
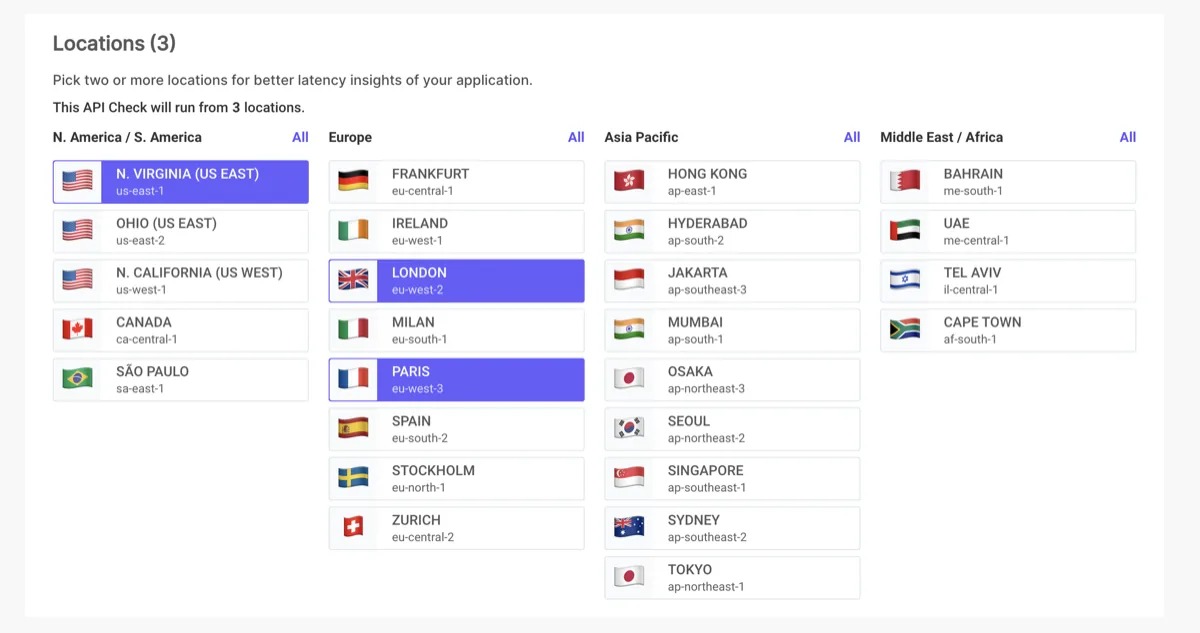
Ejecuta cada check desde varias regiones
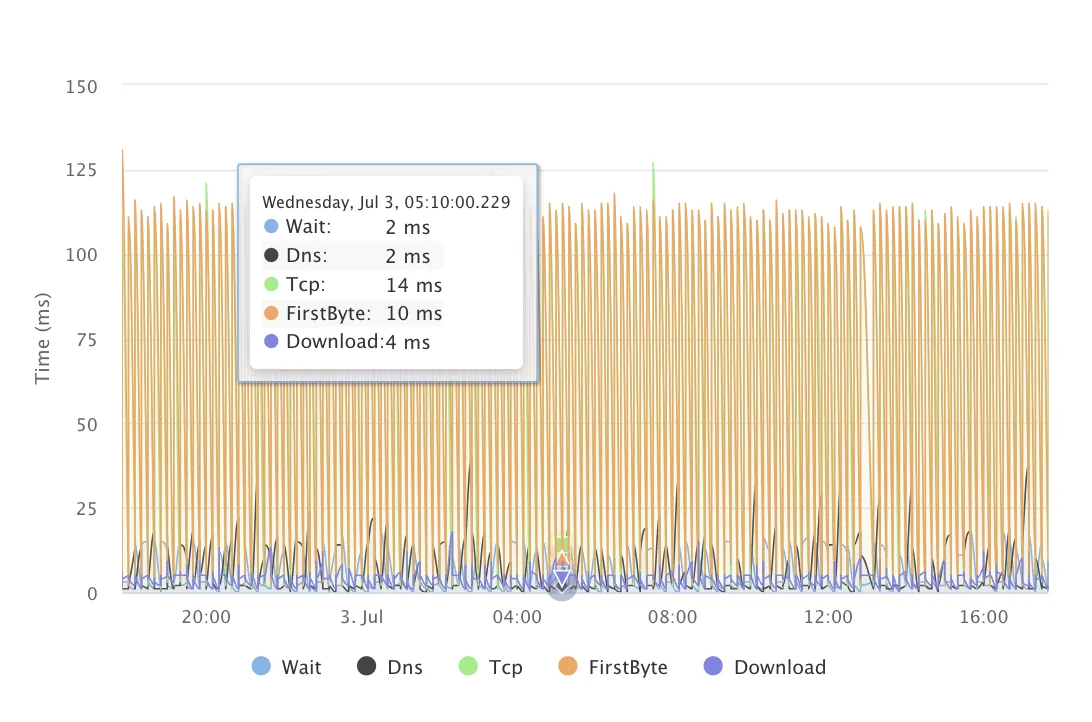
Free y Starter ejecutan un check desde hasta 6 ubicaciones a la vez, y Professional desde hasta 22.
25 regiones para elegir
Regiones en América, Europa, Oriente Medio, África y Asia-Pacífico, entre ellas Virginia, São Paulo, Fráncfort, Londres, Bombay, Tokio y Sídney.
¿Un problema regional o una caída real?
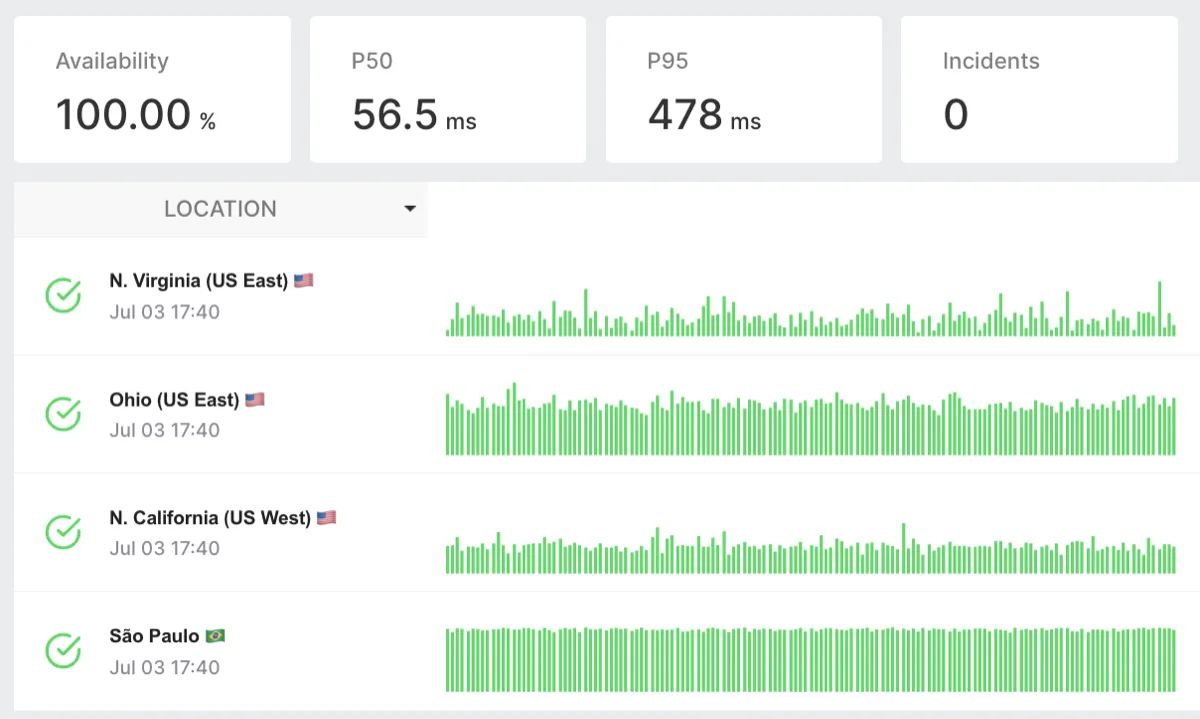
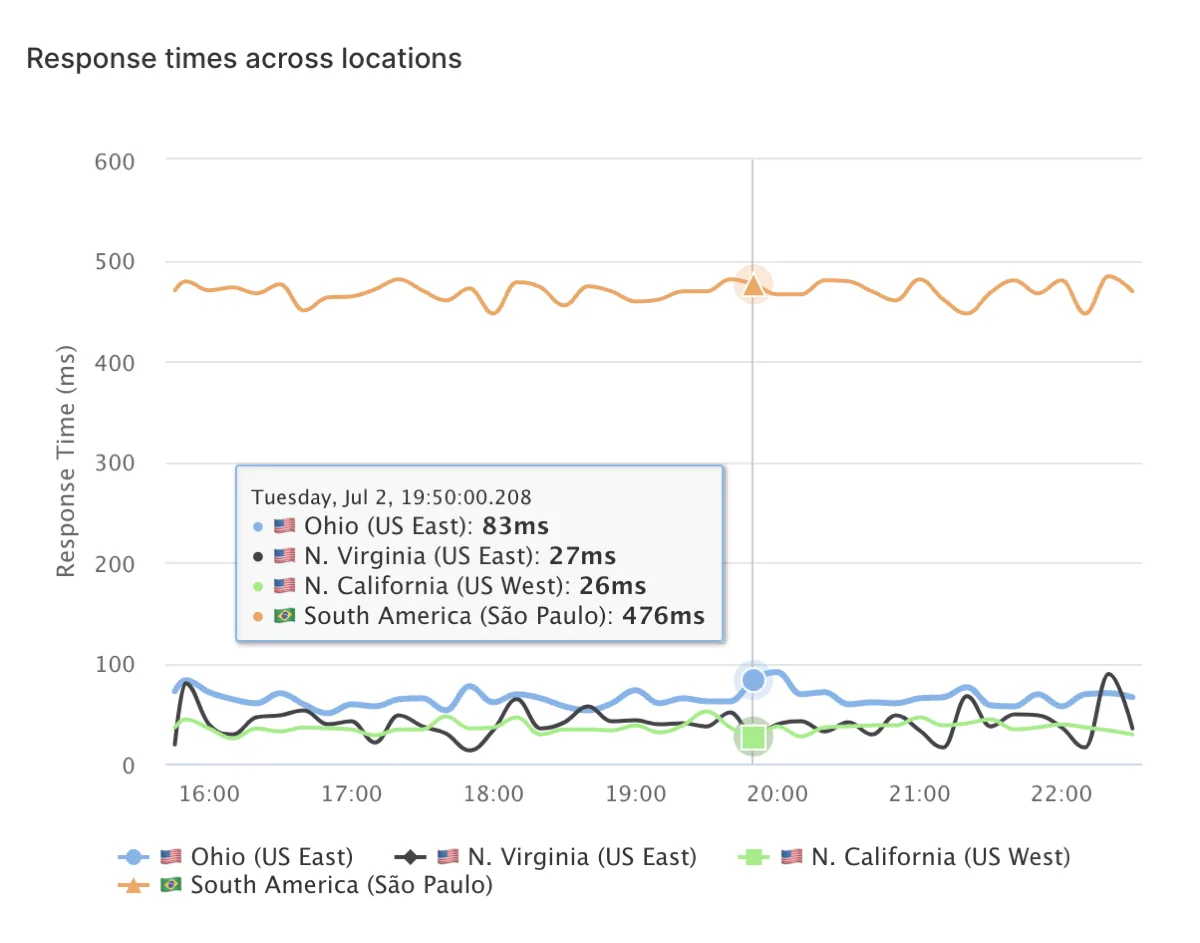
Los resultados por ubicación muestran si una API está caída en todas partes o solo va lenta desde una parte del mundo.
Checks de navegador y flujos API de varios pasos
¿Se rompen tus flujos de usuario entre llamadas API?
Reproduce scripts reales de Playwright en 25 regiones para detectar fallos en login, checkout y otras rutas críticas antes de que lo hagan tus usuarios.
Peticiones encadenadas con traspaso de datos
Pasa valores de un paso al siguiente: extrae un token de la respuesta de login e inyéctalo en la cabecera de la siguiente petición. Sin necesidad de rodeos de scripting.
Fragmentos de código reutilizables
Comparte lógica común entre checks con require('./snippets/nombre'). Actualiza el snippet una vez y todos los checks que lo usan recogen el cambio.
Monitores TCP, DNS y Heartbeat
¿Necesitas monitorizar más que HTTP?
Los monitores TCP verifican que un puerto está abierto y acepta conexiones. Los monitores DNS confirman que tus registros se resuelven a los valores correctos desde 25 regiones.
Monitorización de heartbeat y cron jobs
Envía un ping tras cada ejecución de un trabajo programado. Si el ping deja de llegar, LoadFocus te alerta. Detecta fallos silenciosos en procesos en segundo plano, pipelines de datos y procesos por lotes.
Detecta lo que los checks HTTP se pierden
Un check TCP te dice si el puerto de la base de datos está abierto. Un check DNS detecta problemas de propagación. Un check de heartbeat te dice si el backup nocturno realmente terminó.
Páginas de estado, dashboards y grupos de checks
¿Quieres una vista única de la salud de todos tus servicios?
Las páginas de estado públicas y privadas muestran uptime en tiempo real, historial de incidentes y gráficas de tiempo de respuesta. Informa a tus clientes en el momento en que comienza un incidente.
Grupos de checks y ventanas de mantenimiento
Agrupa checks relacionados y silencia alertas durante ventanas de mantenimiento planificadas. Sin tormentas de alertas en los despliegues, sin falsas páginas a tu equipo de guardia.
Dashboards para cada equipo
Los dashboards compartidos muestran los checks que le importan a tu equipo. Todas las métricas en una vista, desde tiempos de respuesta de API hasta porcentaje de uptime por región.
Monitoring as Code e importación de OpenAPI
¿Quieres gestionar tus monitores igual que gestionas tu infraestructura?
Define checks en YAML o JSON y envíalos via API o CLI. Controla la versión de tu configuración de monitorización junto con tu código y despliega cambios de monitores en CI.
Importación de OpenAPI y Swagger
Apunta LoadFocus a una especificación OpenAPI 3.x o Swagger 2.0 y genera automáticamente un monitor por operación. Sin configuración manual para cada endpoint.
Cobertura consistente desde el primer día
Los nuevos endpoints añadidos a tu especificación reciben monitores en la próxima importación. Los endpoints eliminados se limpian. Tu monitorización se mantiene sincronizada con tu API a medida que evoluciona.