Kontinuierliches Tracking der API-Performance

Überwachen Sie Ihre APIs

Richten Sie mühelos Checks ein, die Antworten, Statuscodes und Antwortzeiten prüfen, und werden Sie sofort alarmiert, wenn Probleme auftreten.

Keine Kreditkarte erforderlich. Kostenloser Plan inklusive; 7 Tage kostenlos testen bei Bezahlplänen.

Überwachen Sie kontinuierlich die Geschwindigkeit, Leistung und Verfügbarkeit Ihrer API-Antworten.

25Cloud-Regionen
1Monat Datenaufbewahrung, kostenlos
10.000Checks pro Monat, kostenlos
1 Min.Prüfintervall in bezahlten Tarifen

Optimieren Sie die Leistung Ihrer API

Sehen, wo jeder Request seine Zeit verbringt

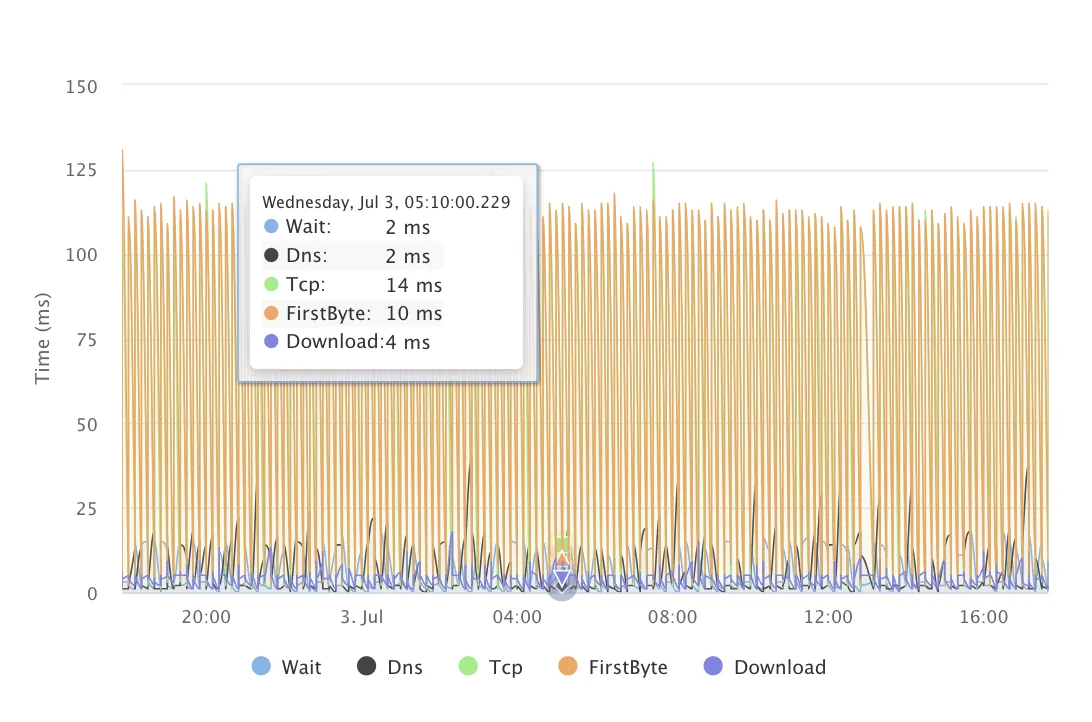
Jeder Lauf zerlegt die Antwortzeit in Wait, DNS, TCP-Verbindung, First Byte und Download, damit Sie wissen, welcher Teil langsamer wurde.

Langsamkeit erkennen, bevor etwas ausfällt

Legen Sie einen Degraded-Schwellenwert für die Antwortzeit fest und werden Sie gewarnt, wenn ein Endpoint langsamer wird, bevor er ausfällt.

Genug Verlauf, um Drift zu erkennen

Free speichert einen Monat an Ergebnissen, Starter 3 Monate und Professional 12, sodass schleichende Verlangsamungen in den Diagrammen sichtbar werden.

Vorteile der Echtzeit-API-Überwachung

Checks bis zu alle 30 Sekunden

Free prüft alle 5 Minuten, Starter jede Minute und Professional alle 30 Sekunden.

Weniger Fehlalarme

Retries, ein Schwellenwert für aufeinanderfolgende Fehler und eine Mindestzahl fehlschlagender Standorte verhindern, dass eine instabile Region Sie alarmiert.

Alerts bei Ausfall und bei Wiederherstellung

Benachrichtigung per E-Mail, Slack, Microsoft Teams, Discord, PagerDuty, Opsgenie oder Webhook, und erneut, sobald die API wieder gesund ist.
Vorteile der Echtzeit-API-Überwachung

Umfassende API-Gesundheitsanalyse

Mehr prüfen als den Statuscode

Prüfen Sie Statuscode, Response-Body, Header und Antwortzeit, damit auch ein 200 mit falschem Inhalt als Fehler zählt.

Mehrstufige Checks für echte Abläufe

Einloggen, den Token an den nächsten Request übergeben und jeden Schritt prüfen, wobei Variablen und Secrets außerhalb des Checks bleiben.

SLA-Berichte aus echten Checks

SLA- und SLO-Berichte machen aus dem Check-Verlauf Uptime-Zahlen, die Sie mit Kunden teilen können.

Wählen Sie LoadFocus für die API-Überwachung

Monitoring und Lasttests in einem Konto

Zeigt ein Check, dass ein Endpoint langsamer wird, starten Sie aus demselben Konto einen Lasttest dagegen und finden Sie seine Grenze.

Statusseiten inklusive

Veröffentlichen Sie eine Statusseite, die von Ihren Checks gesteuert wird; eine Seite ist im Free-Plan enthalten.

Monitoring as Code

Definieren Sie Checks in YAML und deployen Sie sie per CLI aus Ihrer CI, oder verwalten Sie sie über den MCP Server mit einem KI-Assistenten.
Vorteile der Echtzeit-API-Überwachung
Umfassende API-Gesundheitsanalyse

Globales API-Monitoring

Jeden Check aus mehreren Regionen ausführen

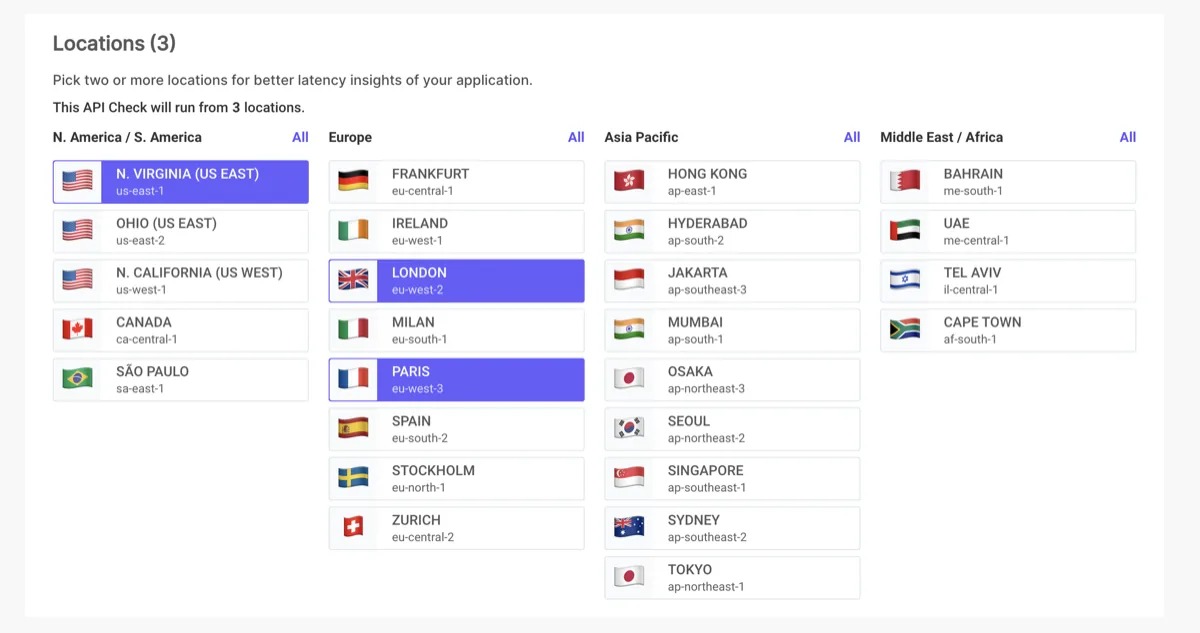
Free und Starter führen einen Check aus bis zu 6 Standorten gleichzeitig aus, Professional aus bis zu 22.

25+ Regionen zur Auswahl

Regionen in Nord- und Südamerika, Europa, dem Nahen Osten, Afrika und Asien-Pazifik, darunter Virginia, São Paulo, Frankfurt, London, Mumbai, Tokio und Sydney.

Regionales Problem oder echter Ausfall?

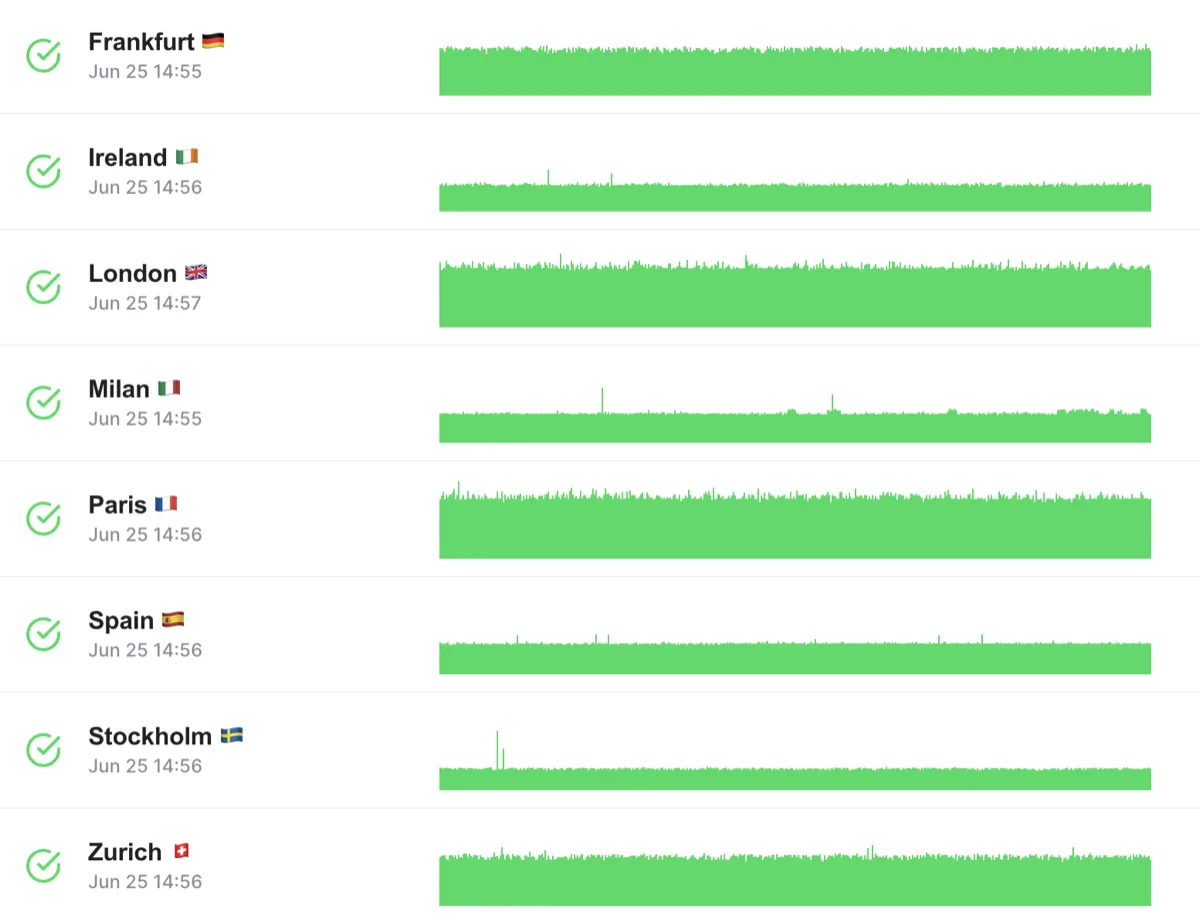
Ergebnisse pro Standort zeigen, ob eine API überall ausgefallen oder nur aus einer Weltregion langsam ist.

Zusätzliche Funktionen

Überwachen Sie jeden Webdienst

Überprüfen Sie jeden Benutzerfluss und erhalten Sie Warnmeldungen über kritische Probleme, einschließlich Webseiten, APIs, SSL, Domainablauf und mehr.

Multi-Location-Checks

Jeder API-Check sollte so konfiguriert sein, dass er von mindestens 2 Standorten aus läuft und falsche Positivmeldungen eliminiert.

Mehrere Benachrichtigungen

E-Mail, Slack, Microsoft Teams, Discord, PagerDuty, Opsgenie und generische Webhooks mit Routing pro Kanal für Ausfall-, Wiederherstellungs-, Degraded- und SSL-Ablauf-Ereignisse. Eine Test-Benachrichtigung wird automatisch gesendet, wenn Sie einen Kanal hinzufügen, damit Sie sicher sein können, dass Alerts ankommen, bevor ein Vorfall eintritt.
Zusätzliche Funktionen

Browser-Checks und mehrstufige API-Flows

Brechen Ihre Benutzer-Flows zwischen API-Aufrufen ab?

Spielen Sie echte Playwright-Skripte in 25 Regionen ab, um Fehler bei Login, Checkout und anderen kritischen Pfaden zu erkennen, bevor Ihre Nutzer es tun.

Verkettete Anfragen mit Datenweitergabe

Übergeben Sie Werte von einem Schritt zum nächsten: Ziehen Sie einen Token aus der Login-Antwort und injizieren Sie ihn in den nächsten Request-Header. Keine Umwege über Scripting nötig.

Wiederverwendbare Code-Snippets

Teilen Sie gemeinsame Logik über Checks hinweg mit require('./snippets/name'). Snippet einmal aktualisieren und jeder Check, der es verwendet, übernimmt die Änderung.
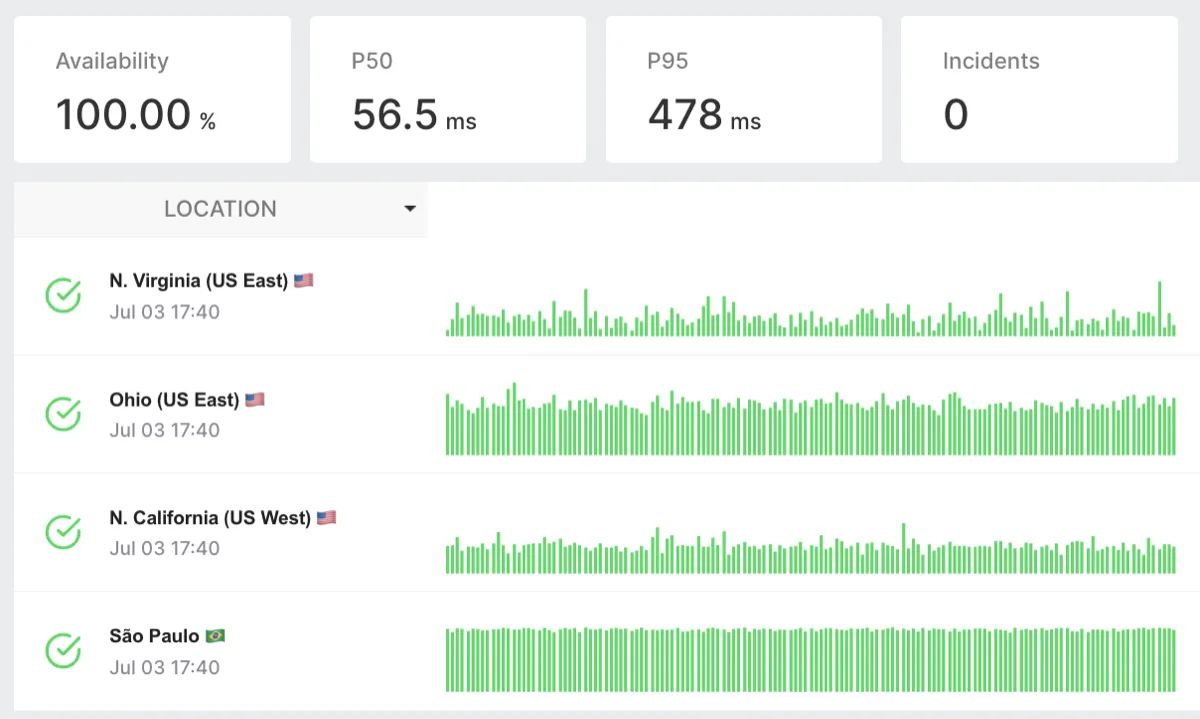
Browser-Checks und mehrstufige API-Flows
TCP-, DNS- und Heartbeat-Monitore

TCP-, DNS- und Heartbeat-Monitore

Müssen Sie mehr als HTTP überwachen?

TCP-Monitore prüfen, ob ein Port offen und erreichbar ist. DNS-Monitore bestätigen, dass Ihre Records aus 25 Regionen auf die richtigen Werte aufgelöst werden.

Heartbeat- und Cron-Job-Monitoring

Senden Sie einen Ping, nachdem jeder geplante Job ausgeführt wurde. Bleibt der Ping aus, benachrichtigt LoadFocus Sie. Erkennt stille Fehler in Hintergrundprozessen, Datenpipelines und Batch-Jobs.

Fehler entdecken, die HTTP-Checks übersehen

Ein TCP-Check sagt Ihnen, ob der Datenbankport offen ist. Ein DNS-Check erkennt Propagierungsprobleme. Ein Heartbeat-Check sagt Ihnen, ob das nächtliche Backup wirklich abgeschlossen wurde.

Status Pages, Dashboards und Check-Gruppen

Möchten Sie alle Ihre Service-Status in einer Ansicht sehen?

Öffentliche und private Status Pages zeigen Echtzeit-Uptime, Incident-Verlauf und Response-Time-Charts. Informieren Sie Ihre Kunden sofort, wenn ein Incident beginnt.

Check-Gruppen und Wartungsfenster

Fassen Sie zusammenhängende Checks zu Gruppen zusammen und schalten Sie Alerts während geplanter Wartungsfenster stumm. Kein Alert-Storm bei Deployments, keine falschen Benachrichtigungen an Ihr On-Call-Team.

Dashboards für jedes Team

Geteilte Dashboards zeigen die Checks, die Ihr Team benötigt. Alle Metriken in einer Ansicht, von API-Antwortzeiten bis zu Uptime-Prozentsätzen über Regionen.
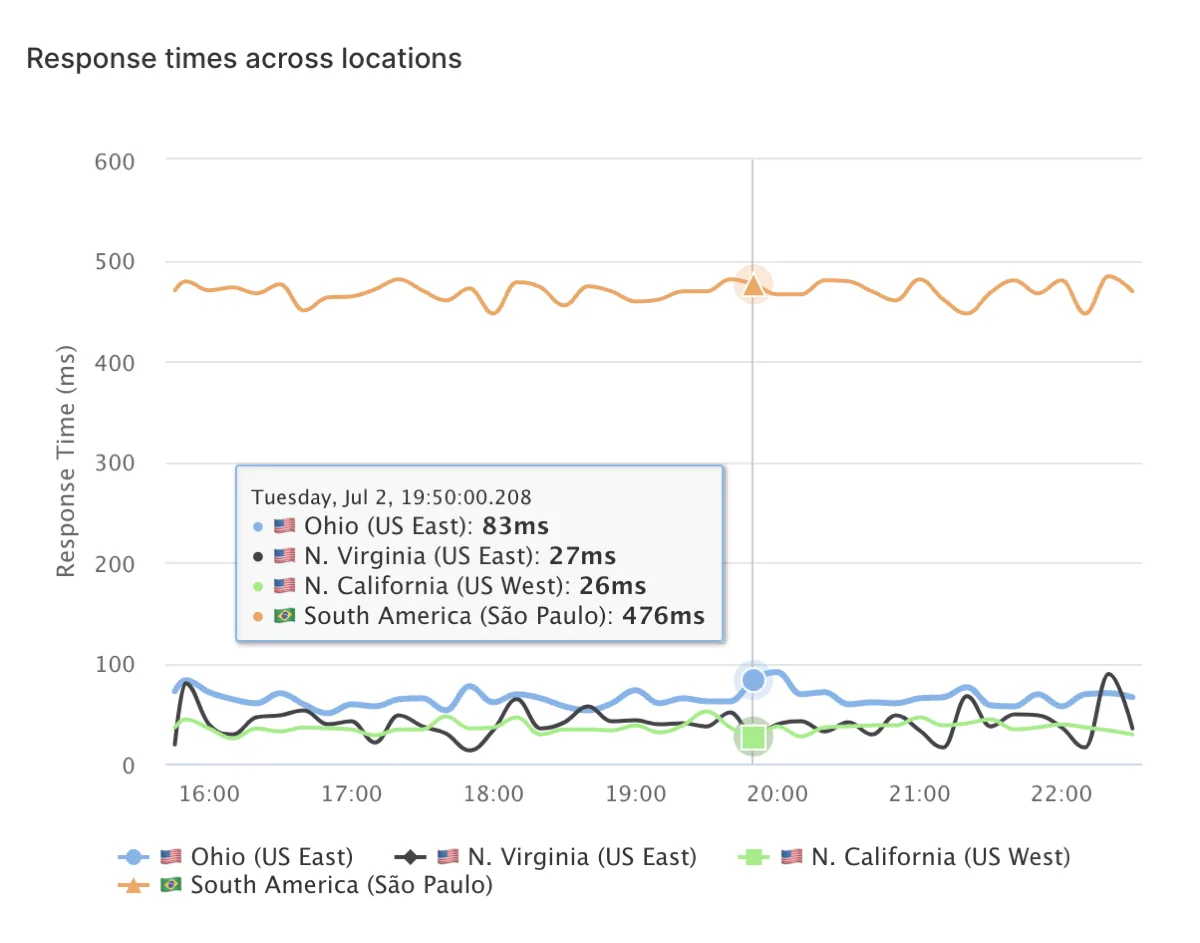
Status Pages, Dashboards und Check-Gruppen
Monitoring as Code und OpenAPI-Import

Monitoring as Code und OpenAPI-Import

Möchten Sie Ihre Monitore so verwalten wie Ihre Infrastruktur?

Definieren Sie Checks in YAML oder JSON und übertragen Sie sie per API oder CLI. Versionieren Sie Ihre Monitoring-Konfiguration zusammen mit Ihrem Code und rollen Sie Monitoränderungen in CI aus.

OpenAPI- und Swagger-Import

Zeigen Sie LoadFocus auf eine OpenAPI-3.x- oder Swagger-2.0-Spezifikation und es wird automatisch ein Monitor pro Operation erstellt. Kein manuelles Einrichten für jeden Endpoint.

Konsistente Abdeckung von Anfang an

Neue Endpoints, die Ihrer Spezifikation hinzugefügt werden, erhalten beim nächsten Import Monitore. Gelöschte Endpoints werden bereinigt. Ihr Monitoring bleibt mit Ihrer API synchron, wie sie sich weiterentwickelt.
Passt zum Rest von LoadFocus

API-Monitoring teilt Standorte, Alert-Kanäle und Statusseiten mit allem anderen in Ihrem Konto.

Uptime Monitoring · Synthetic Monitoring · Cron Job Monitoring · SSL Monitoring · Status Pages · Monitoring as Code

API-Monitoring-Tools im Vergleich. LoadFocus vs. Pingdom, UptimeRobot, Datadog, New Relic

Fünf populäre API-Monitoring-Plattformen verglichen auf den Punkten, die Teams wirklich evaluieren: Check-Frequenz, mehrstufige Request-Flows, kostenloses Kontingent, Alert-Integrationen und Kosten bei realistischer Skalierung.

FunktionLoadFocusPingdomUptimeRobotDatadogNew Relic
Minimale Check-Frequenz30 Sekunden60 Sekunden60 Sekunden (1 Min)30 Sekunden30 Sekunden
Mehrstufige / verkettete API-FlowsJa. Login + Token + CallTransaction-Add-onNeinJa (Synthetic API)Ja (Synthetic Monitor)
Kostenloses Kontingent mit API-ChecksJa. 10 Checks gratisNur Trial50 Monitors / 5 MinNur TrialFrei bis 100 GB Ingest
Globale Check-Standorte25 AWS-Regionen100+1320+20+
Alert-Integrationen (Slack, PagerDuty, Webhook)Ja, alle dreiJaJaJaJa

Die 4 API-Monitoring-Metriken, die Outages wirklich fangen

Uptime allein verpasst degradierte Performance. Diese vier Metriken sagen dir, ob deine APIs wirklich gesund sind, nicht nur erreichbar.

Antwortzeit (p95)

Zeit, die die langsamsten 5% der Requests brauchen. Durchschnittswerte verstecken den Long Tail; p95 deckt ihn auf. Ein p95 über 500 ms bei einer Payment-API heißt: echte Nutzer warten länger als sie tolerieren, und nicht alle kommen zurück.

TTFB (Time to First Byte)

Wie lange die API braucht, um das erste Byte nach dem Eintreffen des Requests zu senden. Fängt DNS-, TLS- und Server-Processing-Slowdowns separat vom Netzwerk-Transfer ab. Spikes hier zeigen meist auf den Origin, nicht auf das Client-Netzwerk.

Synthetic-Check-Erfolgsrate

Anteil der Synthetic-Checks, die bestehen (korrekter Status-Code + Response-Shape + innerhalb des Latenz-Budgets). Werte unter 99% bei einer Production-API sind ein alarmierungswürdiger Vorfall, kein Kuriosum.

Real-User-Monitoring-(RUM-)Korrelation

Synthetic-Checks sagen dir, dass die API läuft; RUM sagt dir, ob echte Kunden dasselbe erlebt haben. Beide kombinieren. Synthetic alarmiert dich bei Outages, RUM zeigt den Kunden-Impact.

API-Monitoring. Häufig gestellte Fragen

Wie oft sollte ich eine API checken?

Production-APIs, die Umsatz treiben oder andere Systeme blockieren: alle 30–60 Sekunden. Interne oder unkritische APIs: alle 5 Minuten reicht. Unter 30 Sekunden kostet mehr, ohne nennenswert mehr Outages zu fangen.

Was ist der Unterschied zwischen Uptime-Monitoring und API-Monitoring?

Uptime-Monitoring prüft nur, ob der Endpoint antwortet. API-Monitoring validiert zusätzlich Status-Codes, Response-Body-Shape, Latenz-Budgets und verkettete Workflows (Login → Token → Call). API-Monitoring fängt die stillen Brüche, die Uptime-Monitoring verpasst.

Kann ich authentifizierte APIs monitoren?

Ja. LoadFocus unterstützt Header, OAuth-Bearer-Tokens und verkettete Requests, bei denen die Response eines Schritts (ein Token) zur Auth des nächsten wird. Kein Service-Account-Passwort im Klartext-Config nötig.

Wie schnell erfahre ich von einem Outage?

Innerhalb eines Check-Intervalls. Mit 30-Sekunden-Checks und Slack-/PagerDuty-Alerts wird dein On-Call in unter einer Minute gepaged. Konfiguriere Alert-Schwellen so, dass 2 aufeinanderfolgende Failures erforderlich sind, das unterdrückt Single-Region-Transienten.

Funktioniert API-Monitoring für GraphQL und gRPC?

Ja. GraphQL ist nur ein POST mit JSON-Body, voll unterstützt. gRPC braucht einen kleinen Adapter (gRPC-Web oder curl über h2), die meisten Teams hüllen es rein fürs Monitoring in einen dünnen REST-Proxy.

Was kostet API-Monitoring im Maßstab?

Die Pläne richten sich nach Checks und monatlichen Läufen. Free bietet 10 Checks und 10.000 Läufe pro Monat im 5-Minuten-Takt, Starter 25 Checks und 25.000 Läufe im 1-Minuten-Takt, Professional 75 Checks und 100.000 Läufe im 30-Sekunden-Takt. Die Preisseite zeigt die aktuellen Preise in Ihrer Währung.

Was ist API-Monitoring?

API-Monitoring sendet kontinuierlich echte Anfragen an Ihre API-Endpunkte und prüft, ob sie antworten, den richtigen Statuscode und die richtigen Daten zurückgeben und schnell bleiben. Es erkennt Ausfälle, Verlangsamungen und fehlerhafte Antworten, bevor Ihre Nutzer es tun, und benachrichtigt Sie in dem Moment, in dem etwas bricht.

Gibt es ein kostenloses API-Monitoring-Tool?

Ja. LoadFocus bietet einen kostenlosen Tarif für API-Monitoring: geplante Prüfungen aus mehreren Cloud-Regionen mit Benachrichtigungen bei Ausfällen und SSL-Ablauf, ohne Kreditkarte. Sie können auch eine sofortige Einzelprüfung direkt im Browser mit dem kostenlosen Multi-Region-API-Statusprüfer ausführen.

Was ist API-Performance-Monitoring?

API-Performance-Monitoring verfolgt, wie schnell Ihre Endpunkte im Laufe der Zeit antworten, und schlüsselt jede Anfrage in DNS, Verbindung, TLS, Time to First Byte und Download auf. Es deckt Latenz-Regressionen und regionale Verlangsamungen auf, damit Sie sie beheben können, bevor sie Conversions kosten.

Kann ich meine OpenAPI- oder Swagger-Spezifikation importieren?

Ja. LoadFocus erzeugt aus einer OpenAPI-3.x- oder Swagger-2.0-Spezifikation, als JSON oder YAML, einen API-Monitor pro Operation. Fügen Sie die Spezifikation ein oder geben Sie LoadFocus ihre URL, wählen Sie eine Häufigkeit, und jeder Endpunkt wird in einem Schritt überwacht, mit Ihren Plan-Limits.

Kann ich eigene Logik vor oder nach einem API-Check ausführen?

Ja. API-Monitore unterstützen Setup- und Teardown-Skripte: Ein Setup-Skript läuft vor der Anfrage (OAuth-Token holen, Anfrage signieren, eindeutige Nutzlast bauen), ein Teardown-Skript nach der Antwort (erstellte Daten aufräumen, Logs bereinigen). Skripte laufen in einer Sandbox mit got, axios, crypto und faker und können Ihre gespeicherten Secrets lesen.

Für Entwickler und KI-Agenten gebaut

Alles auf dieser Seite ist skriptbar. Verwalten Sie Monitore vom Terminal aus, integrieren Sie Checks in Ihre CI-Pipeline oder lassen Sie Ihren KI-Assistenten Monitore anlegen und auslesen.

MCP Server für KI-Assistenten

Verbinden Sie Claude, Cursor oder einen beliebigen MCP-Client mit LoadFocus und erstellen Sie Monitore, starten Checks und lesen Ergebnisse direkt aus Ihrem KI-Assistenten. Einrichtung mit einem Befehl, Auth per OAuth oder API-Key.

Monitoring as Code CLI

Definieren Sie Monitore in YAML und deployen Sie sie mit npx @loadfocus/monitoring aus dem Terminal oder der CI-Pipeline. Versioniert, reviewbar und wiederholbar über alle Umgebungen.

Guides und Dokumentation

Schritt-für-Schritt-Guides für API-Checks, mehrstufige Abläufe, TCP-, DNS- und Heartbeat-Monitore, Alert-Kanäle, Statusseiten und SLA-Reports.

Developers-Seite im Dashboard

Ihr API-Key, Ihre Team-ID und Copy-Paste-Snippets für CLI und MCP Server finden Sie auf der Developers-Seite im Monitoring-Dashboard.

Weiterführende Artikel

Ausführliche Leitfäden zum selben Thema aus dem LoadFocus-Blog (auf Englisch).

Ihre Testtools reichen nicht mehr?

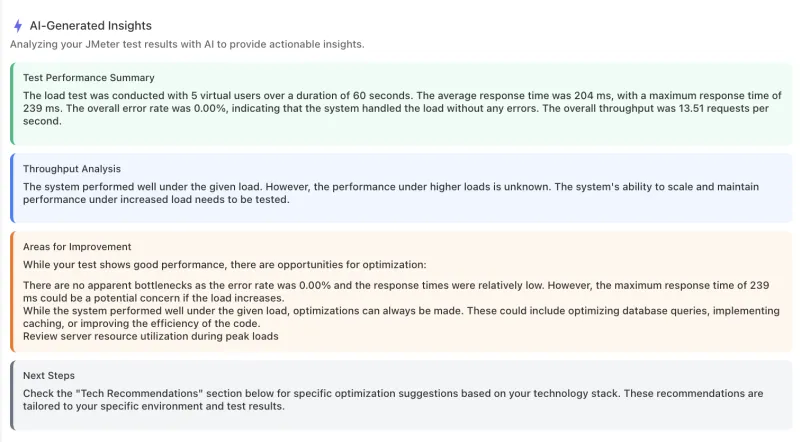
Testen Sie Websites und APIs von 25+ Cloud-Regionen aus, überwachen Sie Seitengeschwindigkeit und Verfügbarkeit, und erhalten Sie AI-Analysen, die Ihre Ergebnisse verständlich erklären.Beginne jetzt mit dem Testen
AI analysis of a load test result: performance summary, throughput analysis, and recommended improvements in plain English

Wir helfen Ihnen, loszulegen

Anwendungsfälle, Einführungsvideos, Tutorials und Anleitungen, mit denen Sie LoadFocus optimal nutzen.

Lernen

Anleitungen zum Erstellen von API-Checks, Verketten von Schritten, Variablen und Auswerten der Ergebnisse.

Erkunden

Produktneuigkeiten, Teststandorte, freizugebende IP-Adressen und White-Label-Berichte.